发布于 2026-10-06 03:05,更新于 2026-10-06 03:32,标签:AI、Agent、技术、DeepSeek、智能体
大肥鱼之躯——从结构与流程解读 DeepSeekHarness
尽量避免源码,从结构与流程的角度讲解 DeepSeekHarness 的设计,感受 Harness 工程化的细节(论 DSH 如何成为大肥鱼最坚挺的脊背)。
本篇是对 DeepSeek 开源仓库
deepseek-ai/deepseek-harness(MIT License)的拆解,内容整理自阅读其源码与官方仓库自带文档的过程,供与我一样初入 Agent 开发的同学参考;文章可能难免出现一定错误,如与其他文档存在出入,请以源码为准。
1. 引入:什么是 Harness 与 Agent?
今年(2026年)8月13日,DeepSeek 终于正式开源了本家Harness —— DeepSeek Harness(后文简称 DSH),这个曾多次被爆料在内测中反复出现的大肥鱼“专武”终于随着 DeepSeekV4-Pro 正式版上线一同发布。
但是 DSH 的架构却出乎很多人意料:相较于 Codex 或者同为国产开源 Harness 的 KimiCode,DSH 选择了更加“模块化”或者“高度自由”的架构。DSH 将 Harness 拆成一个个插件,将 Harness 更多的可能性交给开发者社区自由发挥;这样看似有点“自由散漫”甚至“草台班子”的设计,并没有让 DSH 停留在、或者说仅限于“玩具”的层次,与同样自定义程度很高的 Pi 相比,依托于 DSH 官方自带的一套插件与 DSH 自身较好的设计,DSH 在实际工程任务上有很不错的表现。所以本文尽量不涉及具体的代码,而是从更抽象、更概括的角度带各位来看看像 DSH 这样可以的 Harness 是如何架构、实现的。
首先解释几个概念:大家平时听到比较多的智能体——Agent,相当于 Harness + 模型。Harness 的英语原意指的是骑马用的马具,这个词用于AI就显得很生动了;Harness 就像一个为大模型提供外部工具、让用户能够驾驭大模型完成更多操作的“外骨骼”。在一个 Agent 的工作流中,大模型只需要正常的输出文字,需要什么工具了就给 Harness 发出请求,Harness 负责办妥其他的琐事以及规划下一步的任务。
| 概念 | 说明 |
|---|---|
| 模型(LLM,大脑) | 负责推理与规划,但它本身不能读写文件、执行命令——只能在回答中「声明」自己想调用某个工具 |
| Harness(躯干) | 套在模型外面的工程系统:记忆管理、工具执行、权限控制、界面交互,全部由它承担 |
| Agent(智能体) | 模型 + Harness 构成的完整个体,能自主规划、调用工具、完成任务 |
一个最小 Harness 的核心只是一个循环:问模型 → 模型声明工具调用 → 代为执行 → 把结果追加进上下文 → 再问。DSH 就是这样一个循环的实现——它对“中途取消怎么办”、“进程崩溃怎么办”、“并发执行怎么记账”、“第三方插件不可信怎么办”这些问题都给出了明确答案。DSH 主要用 TypeScript 写成,整个仓库是一个 monorepo,核心代码位于 packages/core/。
再进入正式的解读前,这里还有两组 Agent 中常用的名词,先提前说明一下:
- 轮次(turn)与步骤(step):完成用户一次提示词任务的整个回合称为一个轮次;轮次内部“一次模型请求 + 它引发的全部工具调用”称为一个步骤,一个轮次可包含多个步骤;
- 事件(event)与会话日志(session log):DSH 把会话中发生的一切,包括用户消息、模型回答、工具调用与结果、轮次标记等,都记录为只追加、不改写的事件序列,这份日志是全系统唯一的真相来源(真相来源这个词在这里听起来有点莫名其妙,但是后文会对这个展开阐述)。
2. 一个任务的完整流程
要理解一个 Agent 是怎么架构的,我们不妨先去跟踪一个任务是如何在 Agent 中被一步步拆解、读写、测试、交付的。
某一天的午后,你对着 DSH 敲下一句话:“帮我看看这个项目为什么构建失败”,按下回车。几秒钟后,它开始读你的配置文件、跑构建命令、翻报错日志,最后把修好的文件列表摆在你面前。这中间发生了什么?
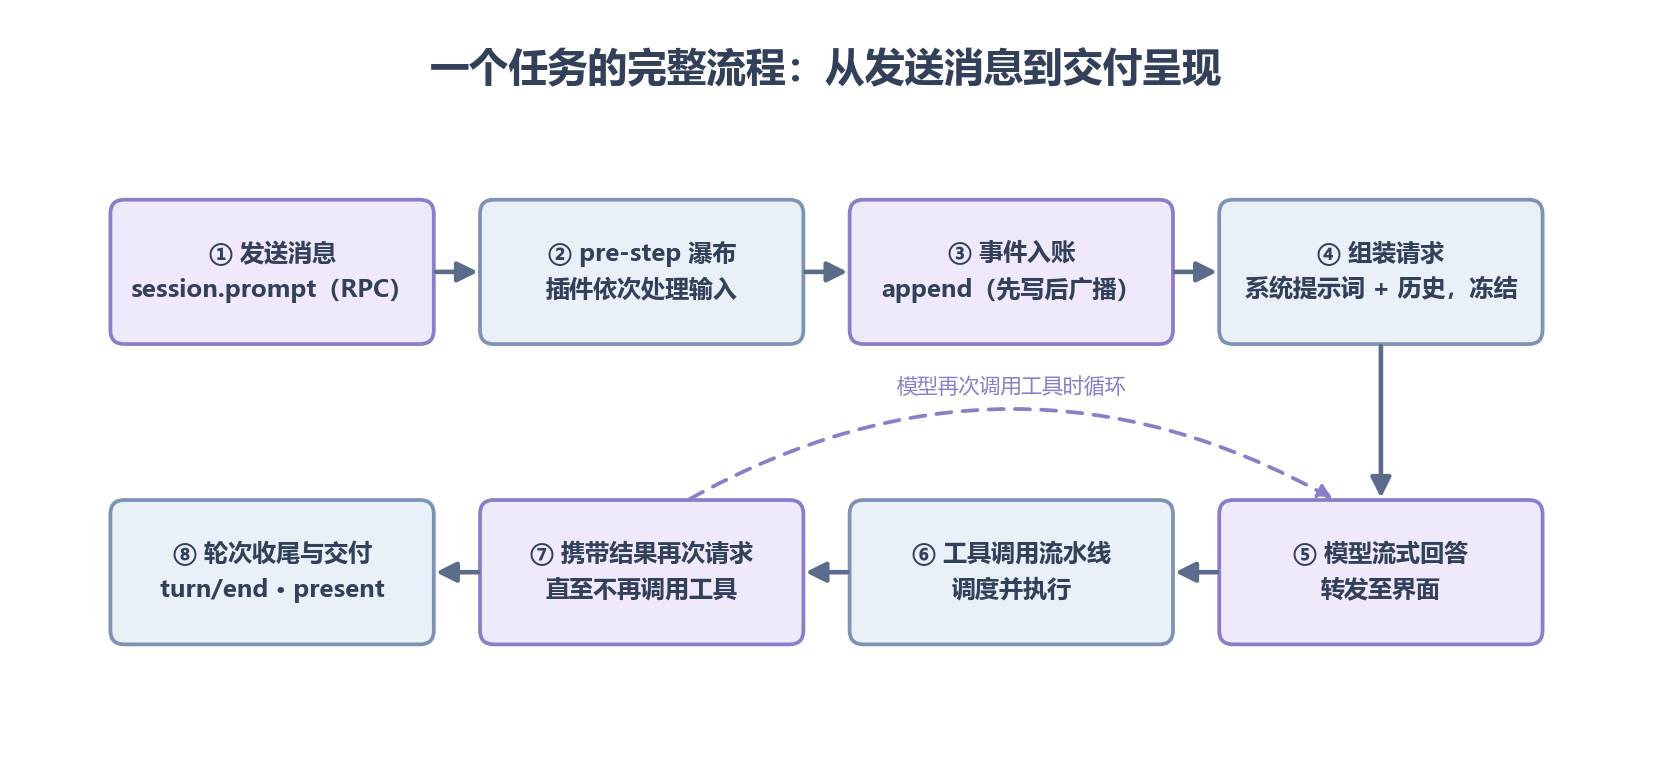
以下是 DSH 中一个任务从发布到完成的流程:
-
发送消息 首先用户通过 UI 界面输入浏览信息、输入提示词,界面通过 RPC 调用
session.prompt把消息提交给后端(Host)。此时的提示词不会直接发给大模型本身,而是先进入 Agent 的收件箱(inbox)。为避免请求重复,每次提交携带 requestId 用于去重,保证用户重复点击发送不会进入两次。 -
pre-step 瀑布 驱动器(Agent Loop;这是 Agent 最外层的大循环,这层循环结束了,一次任务处理的过程就结束了)被唤醒后,先触发
agent/pre-step瀑布事件(“瀑布(waterfall)”就是一条条消息组成的消息流),所有订阅了该事件的插件依次处理这批输入,可以补充、修改,也可以直接拦截。 这就好像在公司的项目组要开始一天的工作前先开一个晨会,领导在会议上报告一系列任务以及消息,每个分工的员工就是一个个监听着事件的插件,只接受和处理和自己有关的事情——比如说此时的上下文窗口已经过长了,上下文压缩(Compaction)插件会在先进行一次浓缩。 全部事件通过后,消息才允许正式写入日志;若用户在此时取消任务,日志中不会留下任何记录。 -
事件入账 通过会签的消息经
Session.append()写入会话日志。这个过程的原则是先写日志、后广播通知:只有落账成功的事件才会被其他插件看到。这一步的详细过程在第 5 节展开。 -
组装请求 系统提示词由各个插件分段提供、按固定顺序拼接,连同会话历史一起组装成请求;请求在发出前被深度冻结(deepFreeze),就好像把最后的请求打包起来,从这里开始,任何插件都无法再修改其内容。 也就是是说,直到这一步组装、冻结之后,请求才即将真正的发给大模型。
-
模型流式回答 请求经模型适配器发给模型,回答以流式返回;驱动器把每个片段封装为转发事件推送到浏览器,界面呈现打字机效果(也就是我们平时看到 Agent 输出都是一点一点向外吐的)。完整回答在落账后才算生效;若被中途取消,已生成的部分以
interrupted标记存档。 -
工具调用流水线 模型没有能干活的手,想做读写文件等事情只能在回答中向 Harness “点单”,即声明工具调用。驱动器先把调用本身落账(
tool/call),再把调用送入工具流水线:审批、守卫、执行、事后处理,这部分会在第 7 节展开讲。多个工具调用可并行执行,但结果一律按模型声明的顺序入账(tool/result)。 -
携带结果再次请求 工具结果追加进历史后,驱动器带着更新后的历史再次请求模型,进入下一个步骤。模型可能继续声明工具调用(回到第5步,形成循环),直到给出最终答复。
-
轮次收尾与交付 模型不再调用工具时,轮次进入收尾:依次执行各插件的收尾检查点(例如工作区变更插件在此生成前后差异快照),写入
turn/end标记轮次落幕;模型通过present工具声明交付物(只记录文件路径,不复制内容),界面据此渲染变更文件卡片与交付卡片。
至此,一个任务走完了一生。
3. 分层架构总览
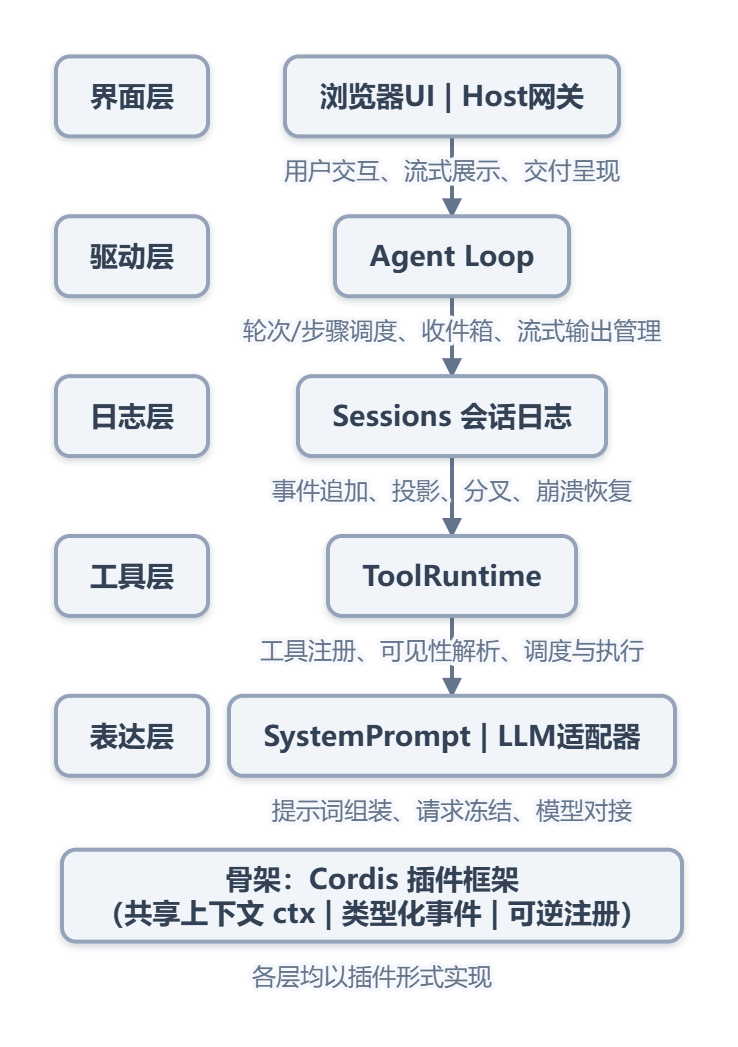
按照职责和任务实现的流程,可以将 DSH 的架构分为以下5层:
| 层 | 核心组件 | 职责 |
|---|---|---|
| 界面层 | 浏览器 UI、Host 网关 | 用户交互、流式展示、交付呈现 |
| 驱动层 | Agent Loop | 轮次/步骤调度、收件箱、流式输出管理 |
| 日志层 | Session 会话日志 | 事件追加、投影、分叉、崩溃恢复 |
| 工具层 | ToolRuntime | 工具注册、可见性解析、调度与执行 |
| 表达层 | SystemPrompt、LLM 适配器 | 提示词组装、请求冻结、模型对接 |
关键的一点是:上面每一层都是插件,插在同一副骨架(Cordis 插件框架)上。接下来就来看看这个骨架是以什么方式实现的。
4. 骨架:Cordis 插件框架
DSH 的底层是 Cordis 插件框架。这里说明一下仓库结构:Cordis 作为第三方框架,其源码以 vendor 方式,即复制进仓库自行维护的方式,放在根目录的 vendor/ 下;而会话日志、系统提示词、工具注册表、模型适配器等部件则是 DSH 自己的插件,官方维护在 packages/ 目录下,仓库自带的几十个能力(上下文压缩、子代理、MCP 接入、守卫、沙箱、交付卡片等常用功能都有官方实现……),确保了 DSH 正常可用的基础。
刚好前两天我们在更新 Spring 相关的博客(给文章引引流),如果你写过 Spring,那就有个蛮生动的类比:Cordis 的共享上下文 ctx 之于插件,类似 ApplicationContext 之于 Bean——插件声明 static inject = ['sessions', 'tools', ...] 即可按名注入其他插件提供的服务,神似 Spring 中通过 @Autowired 装配 Bean()...
Cordis 为插件提供三项基础设施:
- 共享上下文(ctx):按名字获取服务,例如
ctx.sessions操作会话、ctx.llm请求模型; - 类型化事件系统:事件名与参数均有类型约束,插件可发布也可订阅;三种事件模式在第 9 节展开;
- 可逆注册:任何注册动作都必须返回对应的卸载器(disposer),确保插件可随时干净卸载、不留残留状态——热更新与测试隔离都建立在这一约定上。
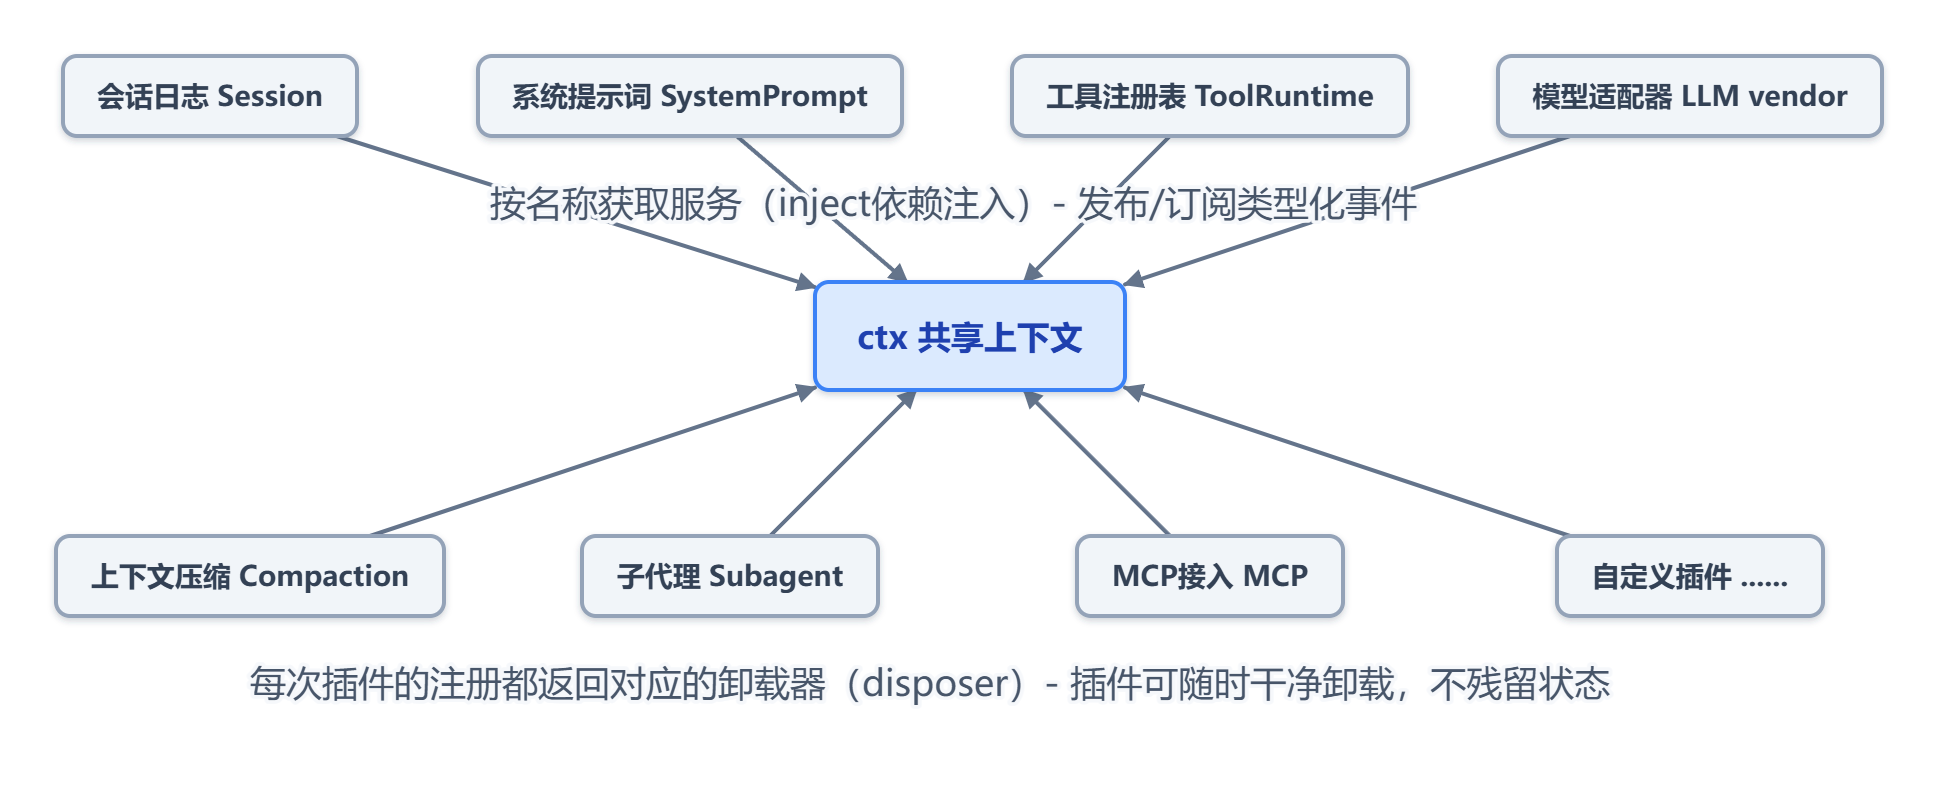
“一切皆插件”直接决定了 DSH 的扩展方式:更换模型供应商就是换一个适配器插件,新增安全策略就是写一个订阅事件的插件,核心业务代码不需要改动。
5. 日志层:Session 会话日志
会话日志是整个系统的真相来源。它类似飞机的黑匣子:只追加、不改写,需要时可以完整还原现场。DSH 设计的一条原则是:模型能看到的内容,一定已经写入日志;日志中没有的内容,模型一定没有见过。回放、分叉、崩溃恢复、遥测分析,全部从这份日志推导。
所谓“真相”,其实是一套“以谁为准”的约定。系统运转时,同一份信息往往同时存在许多副本:模型上下文里的消息列表、界面上显示的聊天记录、收件箱里排队的消息、各插件内存中的状态……这些全都是从日志折算出来的投影,可能滞后、甚至可能出错;而日志是唯一的“正本”,一旦投影与日志出现分歧,一律以日志为准——进程崩溃后,扔掉内存、重放日志,就能精确重建现场。打个比方:会话日志之于 Agent 系统,就像账本之于银行——你 App 里看到的余额只是账本的一份投影,而真正的“真相”永远是账本本身。这也解释了入账环节为什么坚持“先写日志、后广播通知”:一件事只有写进了账本,才算真的发生过。
保证这个设计原则需要规范化日志入账的流程。一条事件写入日志要依次经过五个步骤(packages/core/session/src/index.ts 的 append()):
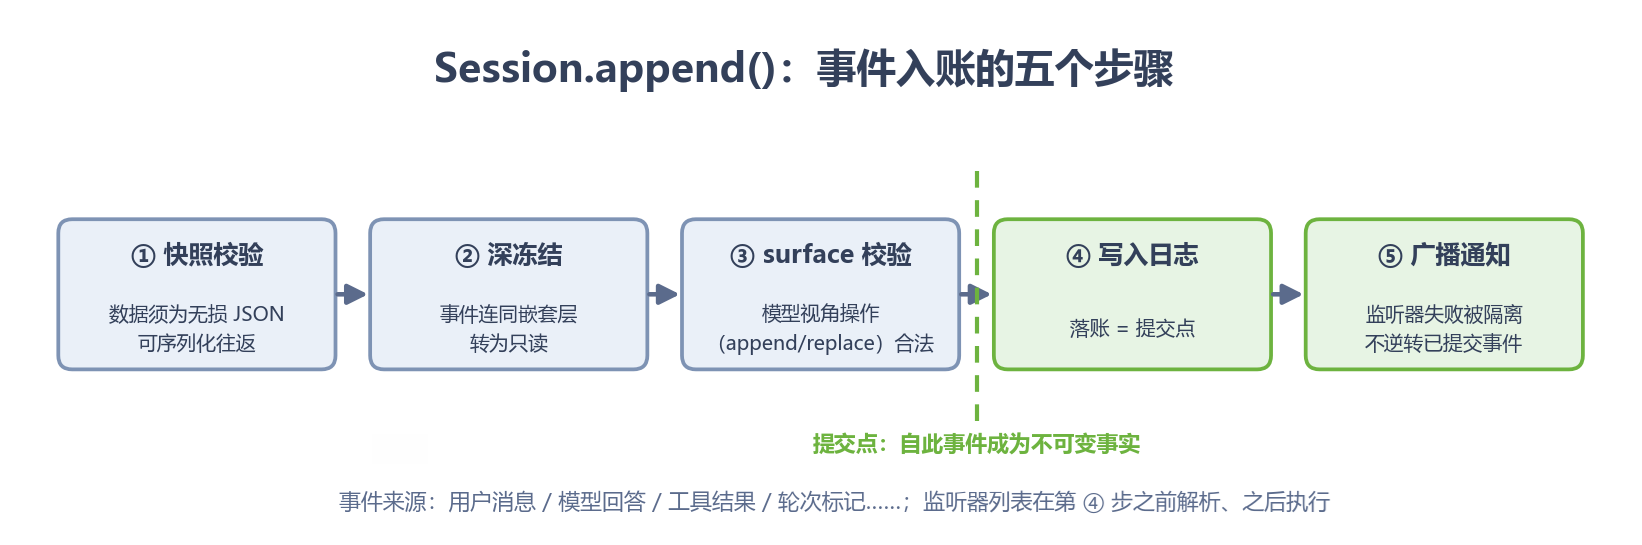
在这五个步骤中有几个值得注意的实现细节:
- 序号即下标:事件的
seq就是它在日志数组中的下标,天然连续;恢复时会逐条校验连续性,不连续即视为损坏; - 深冻结:事件写入前连同嵌套结构一起冻结为只读,此后任何代码都无法修改历史——这不是约定,而是运行时保证;
- 失败隔离:监听器在事件提交后才收到通知,某个监听器抛异常只会被隔离记录,已提交的事件不受影响;
- 增量投影:把事件流折算成“发给模型的消息列表”等视图时,每个折算器维护一个游标,每次只处理新增事件,避免全量重算。
日志层还提供两个生产级能力:分叉与崩溃恢复。
分叉(fork):允许 Agent 从任意事件序号创建子会话,复制该序号之前的历史——相当于保留现场、另开一个分支尝试别的方案;未完成的尾部会被补齐合成收尾事件,已关闭的部分原样保留。这个很类似 git 中的 branch:以某个历史点为分叉点另开一支,父子会话由此连成树;区别在于 git 分支共享同一对象库,而 fork 是把历史实体复制进一条独立的新会话,此后两者互不影响。
崩溃恢复:进程重启后恢复一条会话,严格按四步执行:
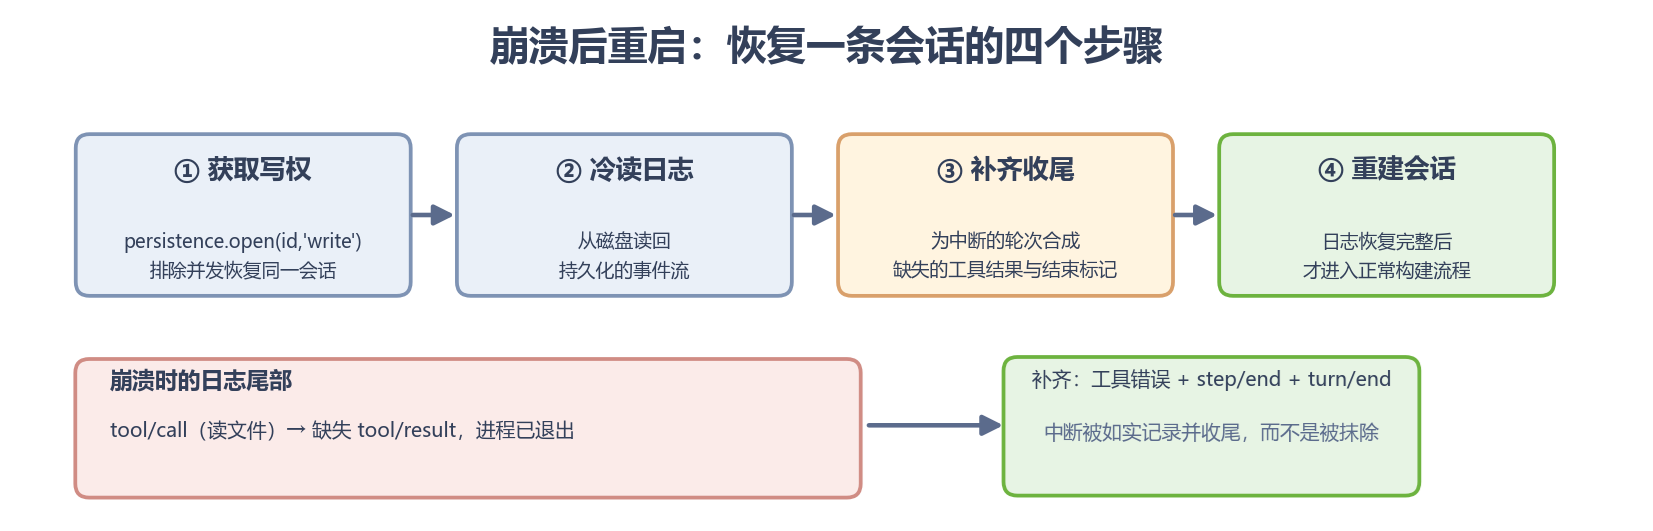
此外,日志文件按版本只增不改写(session.v1.jsonl、v2……格式升级只新增不回头改),且所有“把缓冲事件刷入磁盘”的请求统一经由 SessionStore.flush() 检查点执行,插件不允许绕过。
6. 驱动层:Agent Loop
驱动层的职责是让轮次与步骤构成的循环正确运转,实现位于 packages/core/agent-loop/(核心两个文件合计不到一千行,值得精读)。第 2 节已经走过它的主流程,这里补充三个流程中看不出来的特性:
- 收件箱是持久投影,而非内存队列:收件箱由
agent/inbox/spliced事件折叠重建,写入时先落日志再发通知。因此排队待处理的消息跨重启存活——进程重启后从日志重新折叠,一条不丢; - 流式输出的提交纪律:模型回答边生成边推送,但日志要求“提交才算数”。DSH 规定结束帧只在持久化提交之后才发出(
AssistantStreamAttempt.settle());若提交失败则整次尝试作废。取消时,已推送的内容截断到安全的块边界并以interrupted标记存档——界面上看到的与模型下一轮记得的严格一致; - 有界的并行:模型一次声明多个工具调用时,默认最多并行 10 个(
maxParallelToolCalls),且只有工具自行声明了并发安全(isConcurrencySafe)才进入并行池,其余一律独占执行——分类失败、未声明、声明抛异常,全部按独占处理。
7. 工具层:ToolRuntime
工具层(packages/core/tools/src/index.ts)是全系统防御最严密的部分——这是模型唯一真正能产生副作用的入口。一次工具调用要经过五个阶段:
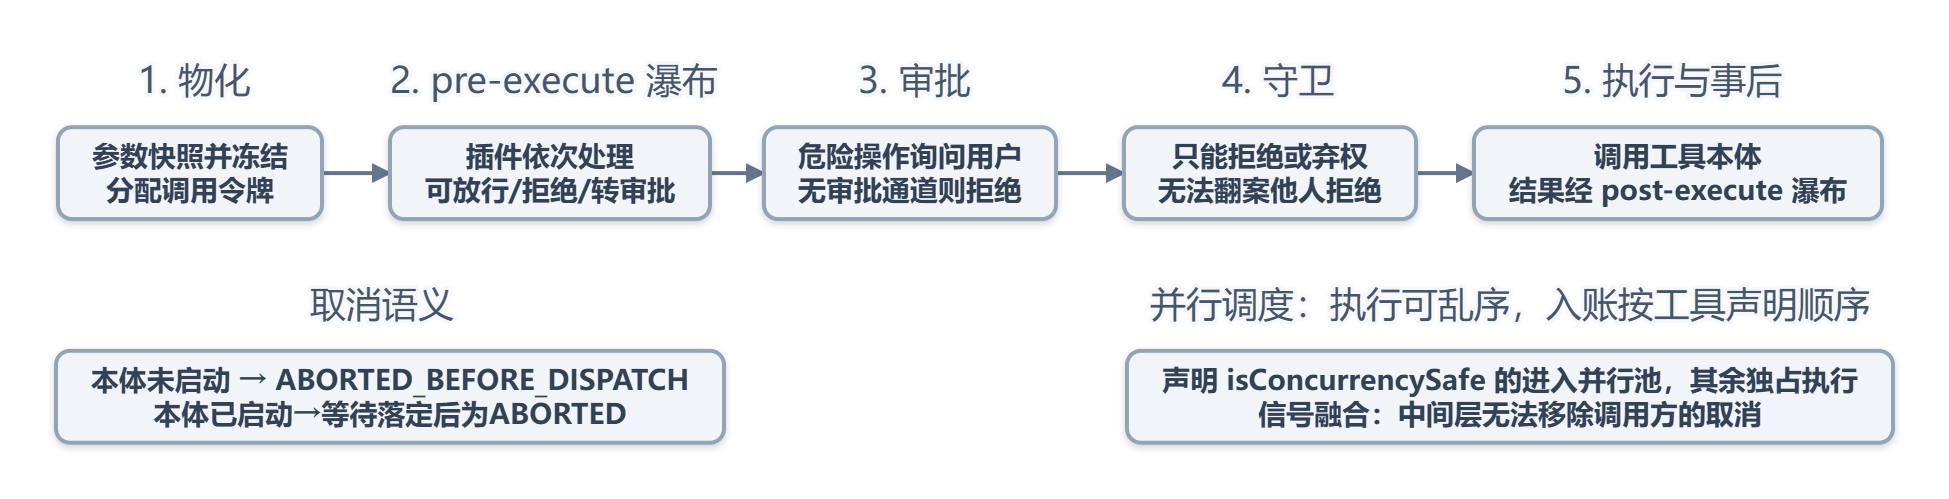
各阶段中值得展开的设计:
- 注定失败的调用不进入策略管道:在 PTC 模式(模型只能通过
run_code写代码间接调用工具)下,模型直接声明其他工具名,会在第1阶段就被拒绝,且错误消息会指明正确路径。审批与守卫永远看不到一个注定失败的调用; - 审批降级是诚实的:未部署审批服务则拒绝;调用没有归属 Agent(无会话可审计、无界面可询问)则拒绝。不同拒绝原因各不相同,模型能区分“用户拒绝”与“没有审批通道”,从而采取不同的后续策略;
- 守卫是单调的:守卫(ToolGuard)的返回值类型中不存在“放行”,只能拒绝或弃权。门禁只会更严、绝不放松:任何插件都无法把其他插件的拒绝翻盘为允许,安全性不依赖插件加载顺序;
- 信号融合:超时、重试等中间层可以替换执行信号,但注册表会把替换后的信号与调用方的原始取消信号重新融合(
fuseToolSignals),中间层无法移除用户的取消权。取消分两种语义:工具本体未启动记为ABORTED_BEFORE_DISPATCH;已启动则不硬杀,等待其落定后记为ABORTED。
工具层还负责回答一个问题:某个 Agent 到底能看到哪些工具?可见性解析 view(scope) 把四层事实按固定顺序合并:
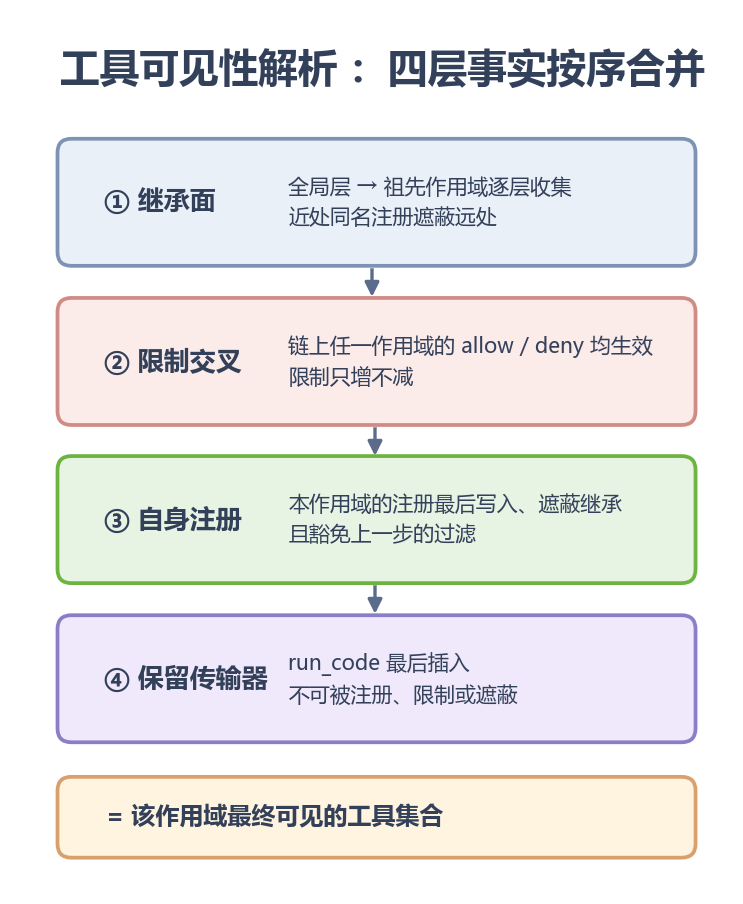
其中“自身注册豁免上一步过滤”是有意设计:委派子任务时,子 Agent 用于交回结构化应答的工具注册在它自己的作用域里,父级下发的能力过滤器不能把这个「应答通道」本身过滤掉。
8. 表达层:提示词组装与模型对接
表达层决定模型最终看到些什么,由两部分组成。
系统提示词由插件分段提供、按序拼接。 身份插件声明“你是谁”,工具插件声明可用工具,安全插件声明边界。这里有一个实际的工程约束:模型的 KV cache 要求提示词前缀稳定,前缀变化会导致缓存失效(变慢且变贵);但“当前时间、当前目录”这类运行时上下文每轮都可能变化。DSH 把提示词组织为节点化的表面(surface):易变内容放在固定节点,变化时替换对应节点而保持前缀稳定,模型每轮拿到新鲜的上下文,缓存命中率不受影响(这也是为什么使用 DSH 时,尤其是在搭配本家的模型时,缓存命中率总能高得吓人)。
请求在发出前被深度冻结。 提示词与历史组装成请求后、进入模型适配器之前,整份请求被深冻结并登记防伪(WeakSet)——相当于盖上了封蜡:所有人都能查看内容,但无人能改动一字。因为请求途中还要经过 llm/stream 瀑布供插件最后过目,冻结保证了任何插件都只能读取、无法篡改——模型实际看到的与日志记录的严格一致。模型适配器本身也是插件,更换供应商只是更换一块插件。
9. 界面层与通信机制
最后是用户可见的一层,以及把所有层串起来的通信机制。DSH 分为 Host(运行 Agent 的后端进程)与浏览器界面两端,两端之间有三条通道:
- RPC 调用:界面主动发起的动作,如
session.prompt发送消息(携带 requestId 去重); - 转发事件:Host 主动推送到界面的实时消息,如流式回答的每个片段——但只有白名单(remotes 清单)内的事件会被转发,内部事件不外发;
- 共享状态:会话列表等界面需要的整体状态,批量同步。
界面层还负责交付呈现:模型经 present 工具声明的交付物只记录文件路径、不复制内容,界面渲染交付卡片时校验文件真实存在,失效则诚实隐藏,绝不指向错误内容;工作区变更的逐行差异由相应插件在轮次收尾时生成快照,界面按需经认证路由拉取。
进程内部,各层插件之间通过 Cordis 事件系统协作,三种模式对应三类场景:
| 模式 | 语义 | 典型场景 |
|---|---|---|
emit(广播) | 通知型,监听器失败互相隔离 | 事件入账通知、工具结果通知 |
waterfall(瀑布) | 依次处理,可修改可拦截 | pre-step 输入处理、请求过目、工具事前/事后策略 |
serial(串行) | 依次执行,保证次序 | 轮次收尾检查点(turn-stopping) |
事件还有作用域过滤:注册在某个 Agent 上的监听器只收到该 Agent 的事件——多 Agent 并行时互不干扰。
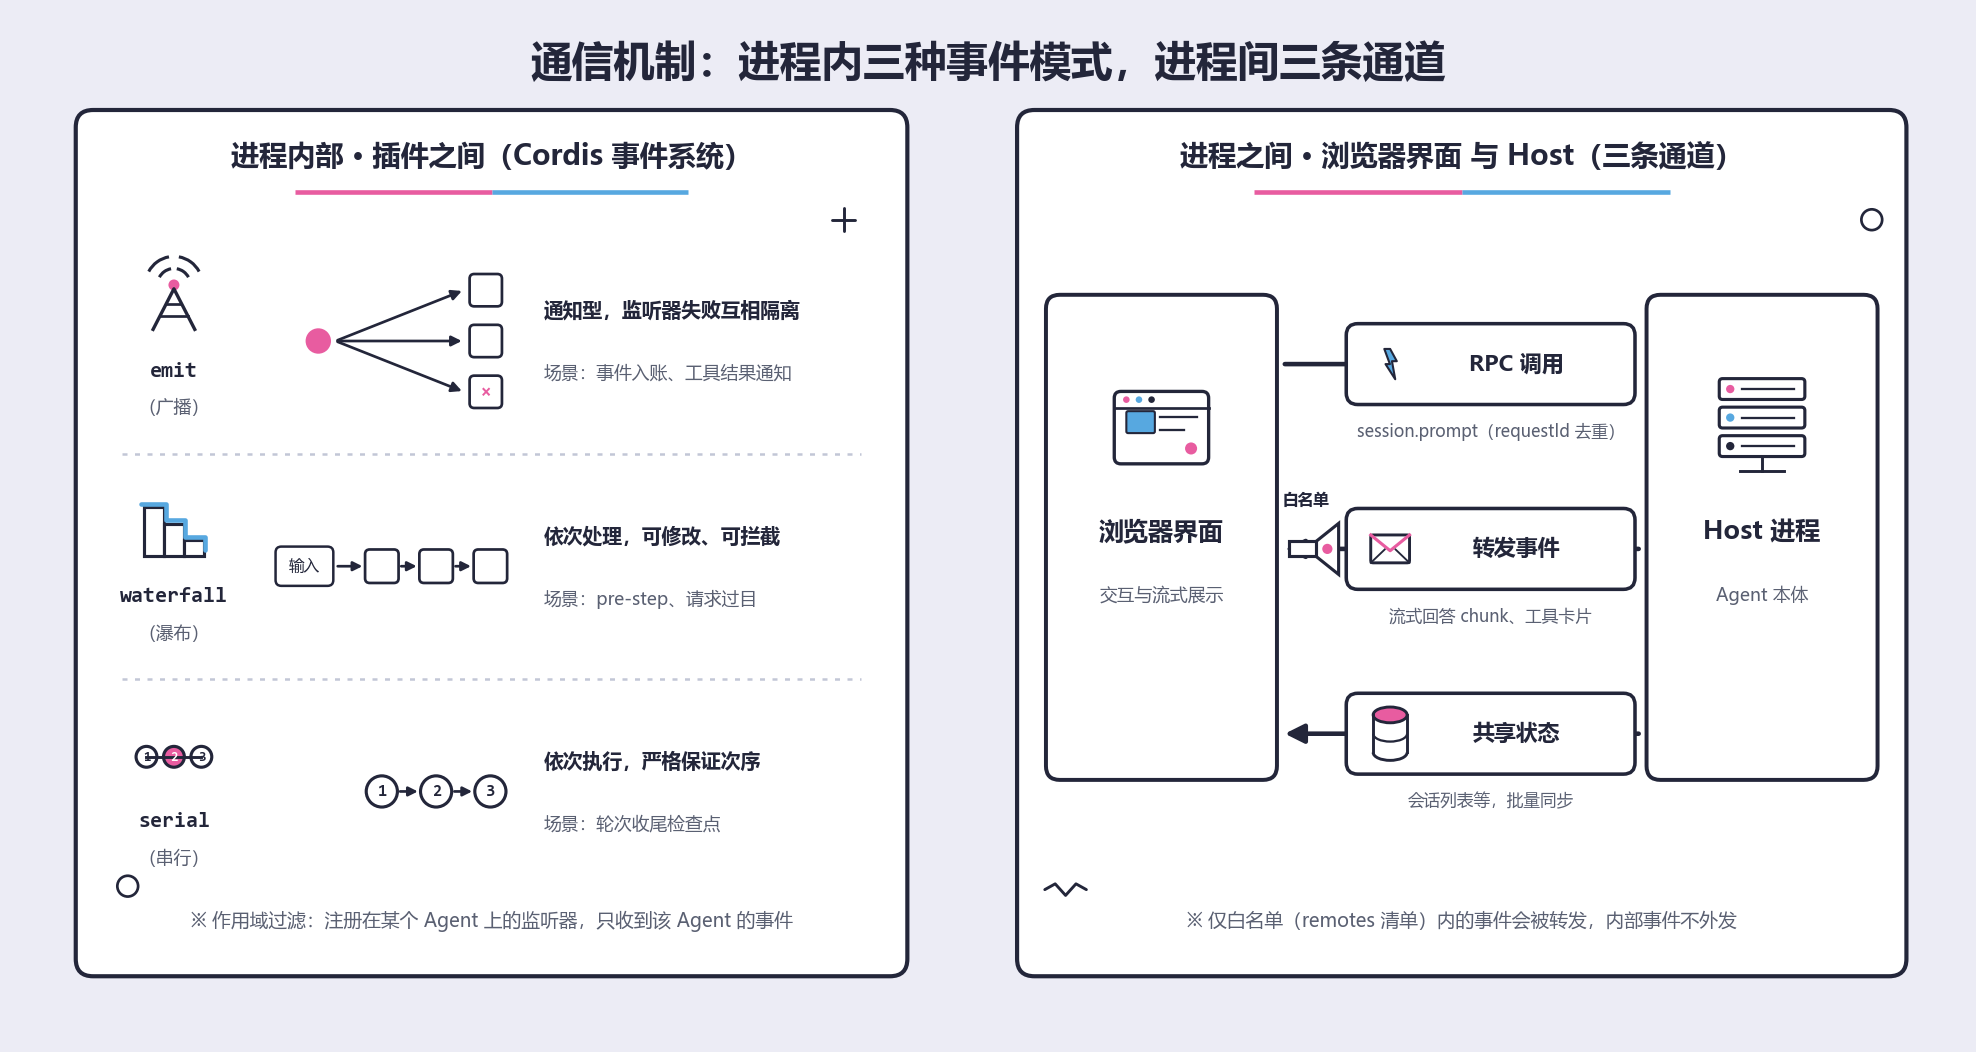
把两侧合起来看,一次工具调用的完整行动路径如下:驱动层发起调用 → 工具层五个阶段(沿途多次 waterfall,按作用域过滤)→ 结果写入日志层(append 五步骤)→ emit 广播 → 白名单内的转发事件推送至浏览器 → 界面上的工具卡片实时更新。每层只处理自己的职责,层间只通过这几类规范的通道耦合。
10. 小结
DSH 的设计可以浓缩为三句话:一切皆插件(Cordis 骨架 + 可逆注册);日志即真相(模型可见 == 已入账);决策点处处对插件开放,但开放不等于失控(单调守卫、信号融合、深冻结)。
- 完整流程:发送消息(RPC)→ pre-step 瀑布 → 事件入账 → 组装并冻结请求 → 流式回答 → 工具流水线 → 携带结果再次请求(循环)→ 收尾交付
- 骨架层:Cordis 提供共享上下文(ctx/inject)、类型化事件、可逆注册;一切皆插件
- 日志层:append 五步骤“先写后广播”;fork 分叉;崩溃恢复按“写权 → 冷读 → 补收尾 → 重建”四步执行
- 驱动层:轮次/步骤循环;收件箱为跨重启存活的持久投影;流式输出提交后才发结束帧;并行默认上限 10,未声明并发安全的一律独占执行
- 工具层:五阶段流水线;审批降级诚实;守卫单调;信号融合保留取消权;可见性四层合并、自身注册豁免过滤
- 表达层:提示词由插件分段拼接;节点化表面保住 KV cache;请求深冻结后发出
- 界面层:RPC / 转发事件(白名单)/ 共享状态三通道;交付只记路径、失效诚实隐藏
- 通信:进程内 emit / waterfall / serial 三模式 + 作用域过滤,进程间三条通道
想进一步读源码的话,推荐顺序:先读仓库的 docs/architecture.zh.md(全景)与 docs/agent-lifecycle.zh.md(正式时序图),然后精读驱动器两个文件 packages/core/agent-loop/src/agent.ts 与 tool-calls.ts(合计不到一千行),再按兴趣深入 packages/core/session/ 与 packages/core/tools/——这两个文件的注释密度极高,几乎每个机制都写明了设计原因,本身就是很好的教材。
回看整个拆解,玩具 Demo 与生产级 Harness 的差距不在功能多寡:取消、崩溃、并发、权限、上下文膨胀……这些“不出事就没人注意”的问题,DSH 逐一给出了工程答案。对开发者而言,通过拆解这种先进且相对成熟(Agent开发方兴未艾,所谓“成熟”也只是相对于小开发团队的Demo来说,DSH 作为 DeepSeek 这种AI龙头企业内部孵化许久的项目,结构上相对成熟稳定;但是他们的核心开发人员崔天翼也说,DSH 尚且处在一个青春期,之后或许会有很多改变架构底层的更新...敬请期待吧)的项目样例不只是学会了“Agent 如何实现”,也为开发者了解 Harness 工程以及自己优化开发 Harness 提供了一份完整的兜底设计清单。其实全文读下来,各位兴许也会发现有很多实现细节我并没有详细展开,这确实是因为这类开源的旗舰 Agent 源码信息量过于庞大,实际上其中仍有很多细节值得继续深挖(比如官方插件中对于子代理委派、沙箱策略、PTC 代码调用模式的实现),今后如有机会,或许会再写一篇笔记。