发布于 2026-08-29 20:04,更新于 2026-09-20 22:37,标签:算法、竞赛、基础算法、回溯
回溯算法浅析:树状、暴搜、递归、剪枝...
讲解了回溯算法的基本设计思想,通过分析题目所指的树状结构,展现回溯算法的本质。
回溯算法浅析:树状、暴搜、递归、剪枝...
各位可能在各路算法大佬的交流中有时会听到诸如“暴搜”、“剪枝”之类的词语;初入算法的新手或许也听说过大名鼎鼎的“N皇后问题”。这些词语都指向一个关键算法思想:回溯法。对于某些难以找到更优解且数据量较小的问题,回溯的思想往往能以优雅的代码解决很多问题。在诸如蓝桥杯之类难度中等的比赛中,回溯法是常考的知识点;在ICPC等更高水平的比赛中,回溯法有时也会结合图论、计算几何等知识点出现在高难度的题目中。本篇便是以尽量生动和简洁的方法来讲解回溯法的算法思想和一些例题的具体代码。
理论基础
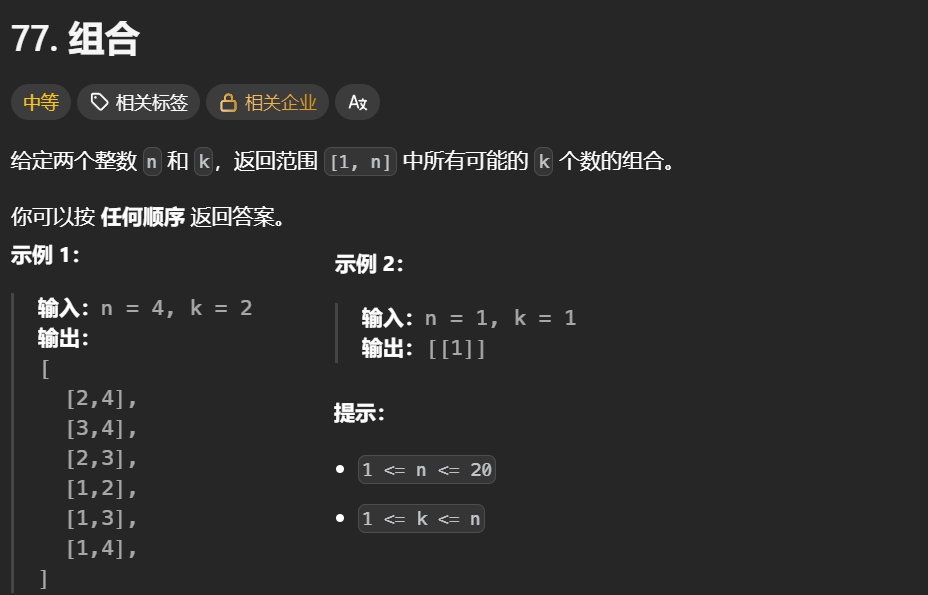
对于这道题,再k = 2的情况下,朴素的想法就是使用两层for循环,用两个指针分别遍历 [1,2,3,...,n] 这个数组。但是数据范围中k最大可与n相等,经过简单数学计算我们也不难发现,本题共有 种可能,本题的时间复杂度是一个关于n和k的幂级数,如果单纯用循环的嵌套要覆盖所有的情况显然是很麻烦的。
所以有没有一种方法,可以不用让我们手动去写这么多层的for循环呢?
有的,兄弟;如果各位对递归或者树有过了解的话,这道题的解题过程我们可以用一棵最大度数为n、深度为k+1的树来表示,比如题中实例一n=4,k=2即可表示为如下的一棵树:
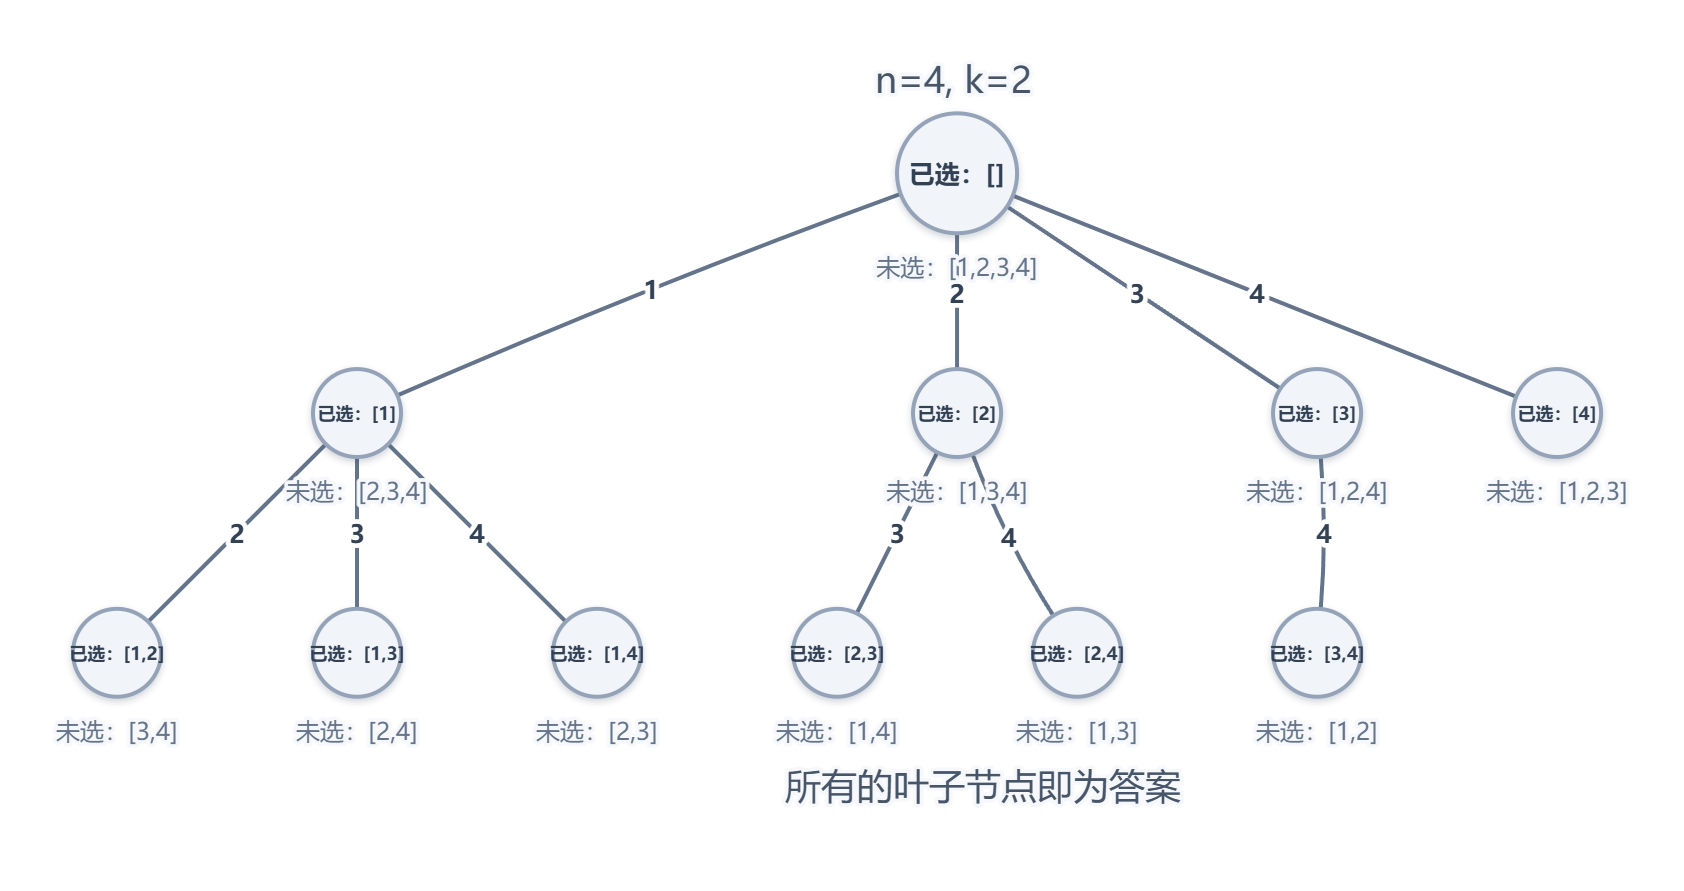
可以看到对于每次选择,都是从剩余的数组中选择不小于上次所选数的数,所有的答案都分布在这棵树的叶子节点上。所以我们只需要想到一种方法可以构建出这样的结构,遍历这棵树,并收回所有的叶结点就好了。
首先我们假设,如果已经有了这棵树,我们应该如何遍历他的每一个节点。
对于《数据结构》这本书有过了解的朋友应该知道,使用递归可以非常简洁的完成树的遍历,代码大致如下:
// 树的先序遍历
if(node == NULL) return;
visit(node -> data);
preOrder(node -> leftChild);
preOrder(node -> rightChild);
我们可以将这个遍历过程看成三个部分:
-
递归终止条件:
if(node == NULL) return;如果当前遍历到的节点指向空指针域,则结束; -
收获递归结果:
visit(node -> data);访问当前遍历到的节点并收获结果; -
传递信息进入下一层递归:
preOrder(node -> leftChild); preOrder(node -> rightChild);将当前节点的左右孩子的指针传给递归函数。
不难理解,本题获取书的叶子节点的过程和上述遍历一棵树的过程很像,用示意图表示如下:
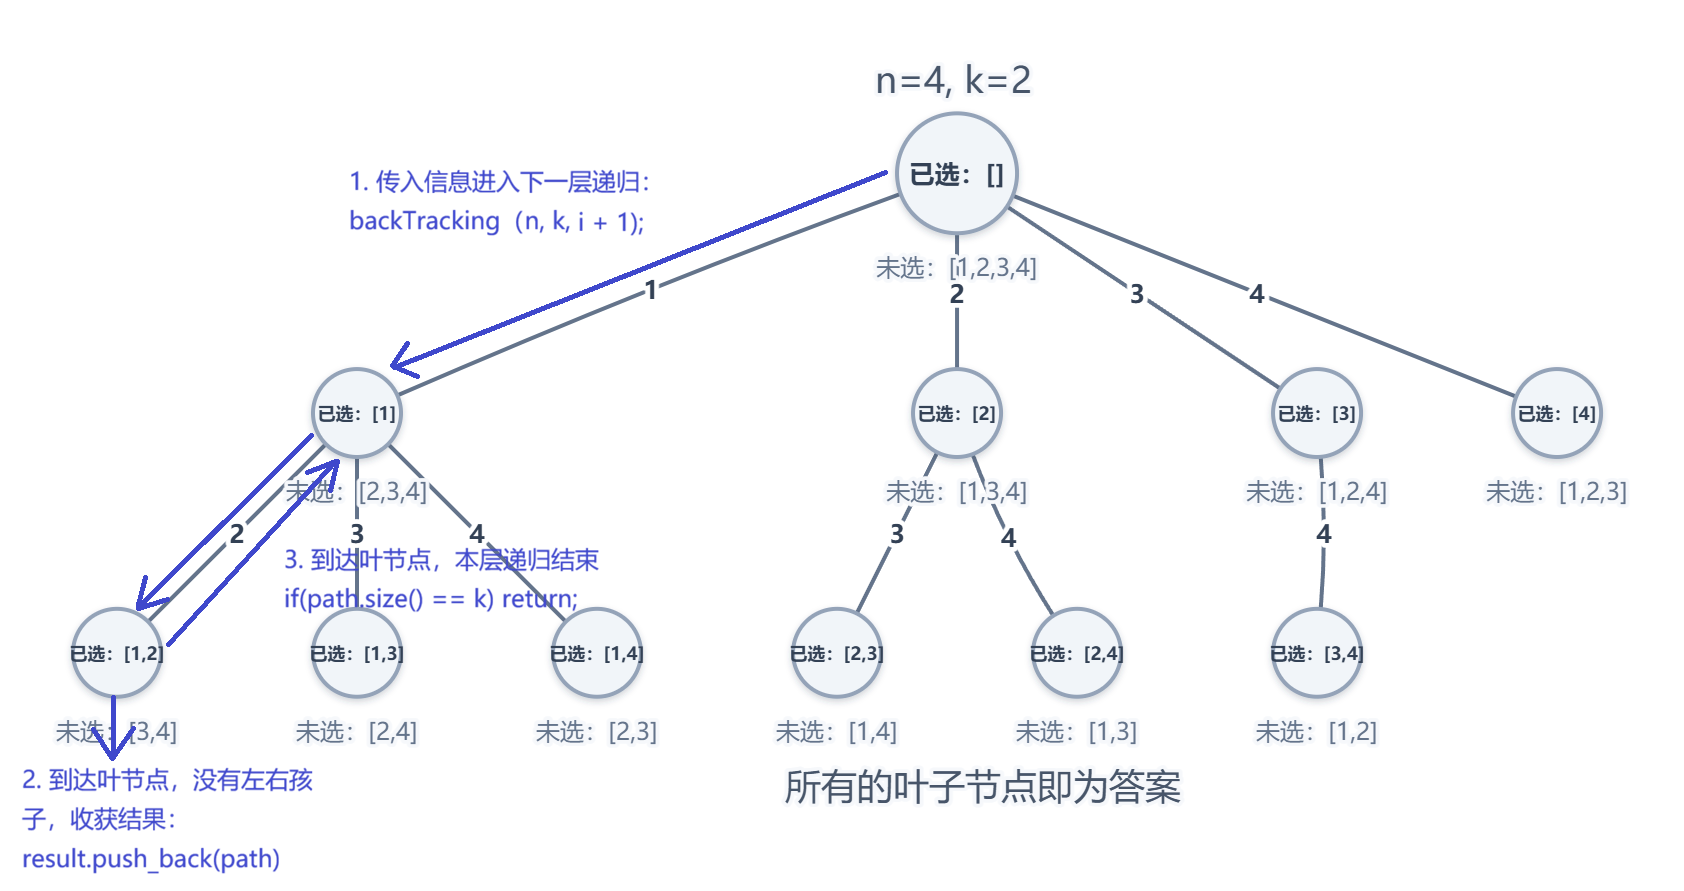
与遍历树相比只是在收获结果时有一些差别。
既然知道了如何收获结果,那来思考下如何构建出这样一棵树吧。
实际上我们不需要真的去定义一个树节点的类,也不需要真的去模拟一棵树,通过递归函数传值就可以在数组上模拟出“访问孩子节点”、“节点是否为叶子节点”的情况。
我们先定义一个一维数组vector<int> path,它用于收集沿途所选择的数字,表示当前这个遍历下的一个合法答案;再定义一个二维数组vector<vector<int>> result,这是由于LeetCode每道题只要求完成一个函数,而不像ICPC那样包含完整的输入输出,所以需要result数组来保存每一个合法结果,最终再工具类方法中将其交付,如果是ICPC等可以直接输出的平台,则不需要这个数组。
由于这道题的要求的数组是 1~n 连续的,所以我们没必要创建一个真正的数组,可以直接对数字进行操作。
接着,我们应该思考下递归函数应该传入哪些参数:n要传入,代表 1~n 这个区间,表示我们操作数组的边界;k要传入,一旦path中收集的数字的总数等于k,就说明递归已经达到了树的叶子,这时候要收获答案了;除这两个外,我们还需要传入一个参数,来表示当前这一层应该从哪一个数字开始收集,本文将其命名为startIdx。所以递归函数的结构被声明成void backTracking(int n, int k, int startIdx);。
在这个递归函数里面,我们应该将循环变量 i 从startIdx开始,逐一将不大于 i 的数字推入path,但是每推入一个数字,就相当于递归进入了另一个分支,所以就需要在一个for循环中调用自身。
注意,本题题意是要所有的“组合”;组合是无序且不能重复选取同一元素的,所以我们要保证下一层递归开始时选取的第一个数字,要大于当前选取的数字,不然就会出现之前的分支中收获了[1,2],然后后面的分支收获了[2,1]的情况。
所以我们的循环体就该写成如下的样子:
for(int i = startIdx;i <= n;++i){
    path.push_back(i);  // 收集当前的数字
    backTracking(n, k, i + 1);  // 下一层从 i + 1开始,严格保证path递增
    path.pop_back();  // 上一层递归结束,弹出最后一个数,重新遍历
}收获答案的过程如上述,触发是path.size() == k;。
所以我们就能得到完整的过题代码:
class Solution {
private:
    vector<int> path;
    vector<vector<int>> result;
    void backTracking(int n, int k, int startIdx){
        if(path.size() == k){
            result.push_back(path);
            return;
        }

        for(int i = startIdx;i <= n;++i){
            path.push_back(i);
            backTracking(n, k, i + 1);
            path.pop_back();
        }
    }

public:
    vector<vector<int>> combine(int n, int k) {
        backTracking(n, k, 1);
        return result;
    }
};
通过这道题,我们就能得出一个回溯算法的大体结构:
递归:
    满足收获条件:收获结果
	循环部分:
调用递归;这个结构看起来就像是一个递归函数帮我们控制着for循环所需要嵌套的层数一样,而把startIdx + 1就好像多层循环里面,写(int j = i + 1;j <= n;++j)来保持结果单调递增有异曲同工之妙。
多个集合问题
LeetCode 77中我们所操作的数组只有一个,但是对于像LeetCode 17.电话号码的字母组合这样需要对多个集合做操作的题目,
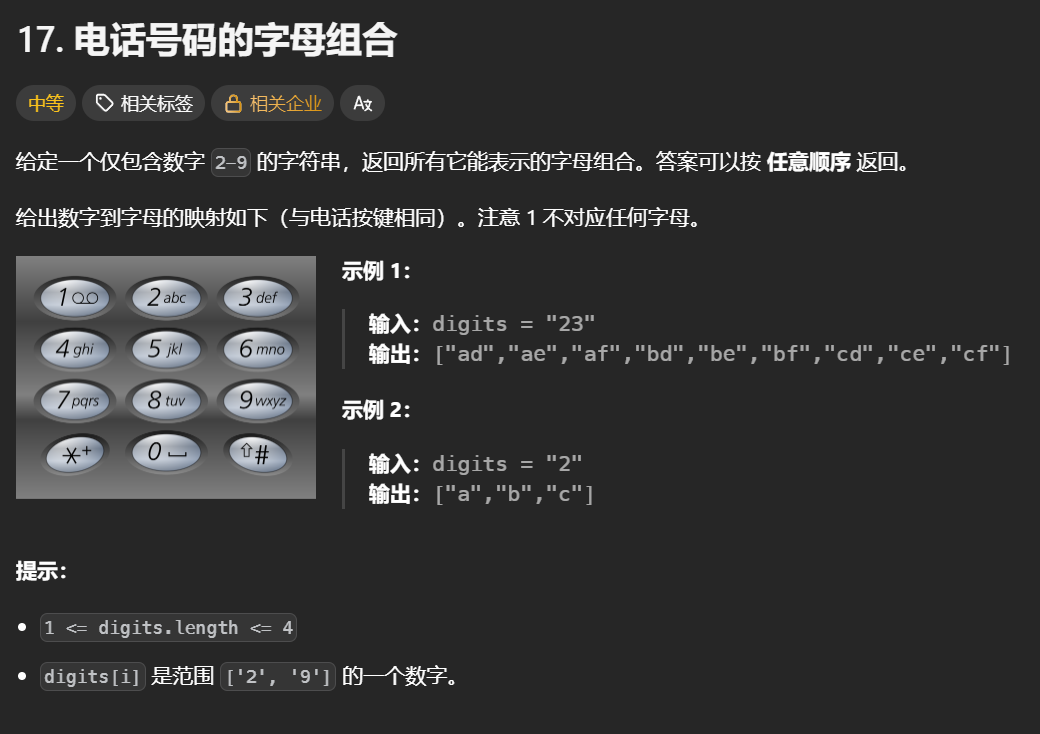
其实也只是多了一个map映射,并在递归时将原本代表从哪个索引开始收集的startIdx,变成现在该收集哪个数组中的内容的idx。
过题代码如下:
class Solution {
private:
    map<char,string> digit_to_string;
    string path;
    vector<string> result;
    int init = 0;
    void backTracking(int length, string digits, int idx){
        // 仅一次初始化,创建一个数字到所有字符可能性的映射
        if(init == 0){
            digit_to_string['2'] = "abc";digit_to_string['3'] = "def";
            digit_to_string['4'] = "ghi";digit_to_string['5'] = "jkl";
            digit_to_string['6'] = "mno";digit_to_string['7'] = "pqrs";
            digit_to_string['8'] = "tuv";digit_to_string['9'] = "wxyz";
            init++;
        }

        if(path.size() == length){
            result.push_back(path);
            return;
        }

        for(int i = 0;i < digit_to_string[digits[idx]].size();++i){
            path.push_back(digit_to_string[digits[idx]][i]);
            backTracking(digits.size(), digits, idx + 1);  // 从下一个字符集中选取
            path.pop_back();
        }
        return;
    }

public:
    vector<string> letterCombinations(string digits) {
        backTracking(digits.size(), digits, 0);
        return result;
    }
};
当然,不同的题目解法会略有差异,但是回溯算法的整体思路与框架和LeetCode 77的原型实际并没有什么差别。
剪枝
LeetCode 77中,我们的代码中,只要一个path中收集到了k个元素,那就一定是合法答案,可以直接收集。
但是诸如LeetCode 216.组合总和III这样的题目,
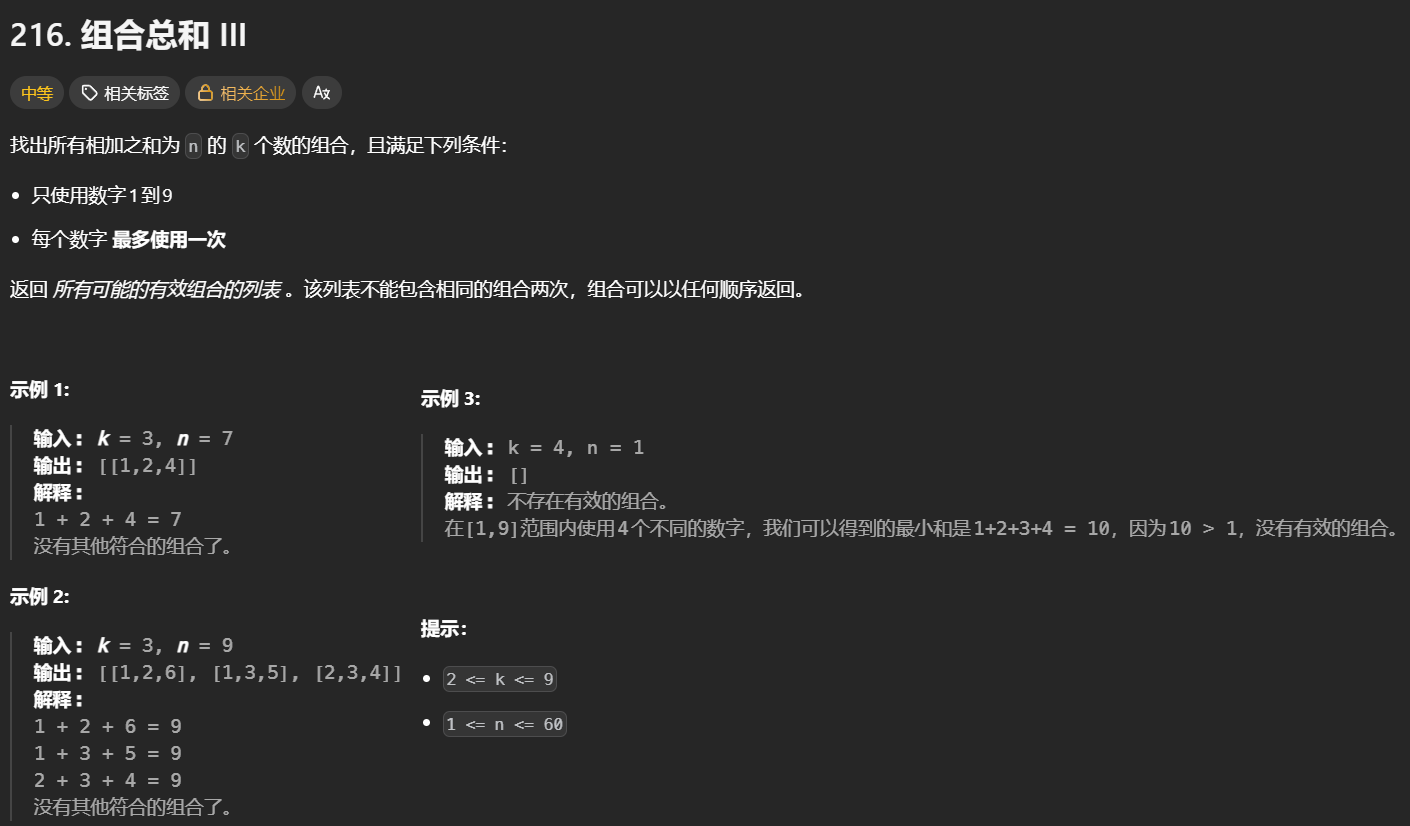
对于一个递归的分支,有些分支最后的结果并不合法,因为不一定所有长度为k的path都能满足总和等于n,所以在收集答案前我们需要再校验一遍path中所有数字的总和是否等于n。
但这样做可能会导致有些在中途就发现不可能的分支直到收集答案这一步才发现不合法,会浪费一定时间。所以剪枝的想法就是在过程中就去剪除一些已经不可能合法了的答案。
本题过题代码如下,我们结合着代码看:
class Solution {
private:
    vector<int> path;
    vector<vector<int>> result;
    void back_tracking(int k,int n,int start_idx, int sum){
        if(path.size() == k){
            if(sum == n) result.push_back(path);
            return;
        }

        if(sum > n) return;

        for(int i = start_idx;i <= 9;++i){
            path.push_back(i);
            back_tracking(k, n, i + 1, sum + i);
            path.pop_back();
        }
    }

public:
    vector<vector<int>> combinationSum3(int k, int n) {
        back_tracking(k, n, 1, 0);
        return result;
    }
};
这里的递归函数参数多一个表示当前总和的sum,除了在path的长度已经等于k的时候进行sum是否与n相等的检查之外,其实在中途一旦发现这时候的sum已经大于n了,就可以将这个分支剪除。
如果各位代码直觉强,其实可以发现这段代码的剪枝实际上不充分:由于这道题每组最多可选k个数字,所以 i 并不需要老老实实遍历到9,所以for循环中也可以进行一次剪枝操作。
        int need = k - path.size();  // 还需要几个数
        for(int i = start_idx;i <= 9 - need + 1;++i){
            path.push_back(i);
            back_tracking(k, n, i + 1, sum + i);
            path.pop_back();
        }
由于LeetCode 216这道题数据量实在过小,且测试点也很少,所以简直带来的收益并不明显。但是在难度更高的题目中,剪枝操作某些情况下甚至是必要的,否则就可能TLE或者MLE栈溢出。
综上,剪枝是对回溯的优化方法,他的收益不是稳定的,对于不同的测试集会表现出差异很大的优化效果。
去重
在某些题目中,可能会出现集合中有重复元素,数值相同、次序不同的元素视作不同的元素;答案中可以选取数值相同的元素、但是不能选取同一个元素。这样的题目往往会涉及去重问题。
思考下我们在LeetCode 77那道题中如何避免选取到诸如[1,1]这样元素重复的非法答案的?使用startIdx。每个分支传入的startIdx都是上一轮遍历到的 i 再加上1,所以永远不会选到自身。但是对于LeetCode 90.子集II这道题,
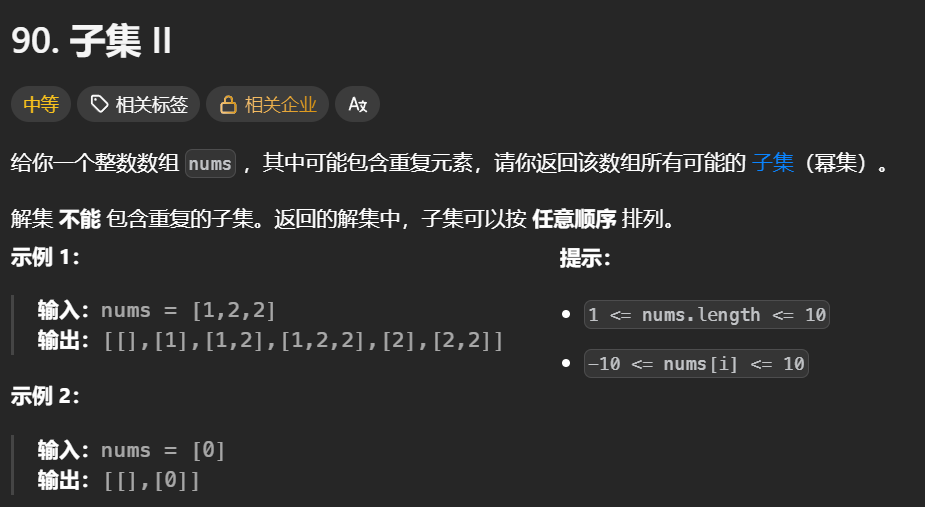
只通过后移startIdx并不能解决重复集合的问题。尽管不选取同一位置上的元素,在nums=[1,2,2]时,有一条分支选取了[1,2(第一个2)],另一条分支仍然会选取[1,2(第二个2)]。
去重的方法有很多:排序+used数组,排序+startIdx标记,或者粗暴的简历建立一个unordered_set去校验这个元素有没有被用过......所以限于篇幅 (站长懒了),如果后续有需求 (或者哪天实在没有东西能写了),我会再单独发一篇介绍几种去重思想的博客 (实际上多数情况下用set去重就够了,有复杂度要求另说) 。
这道题所用的去重方法是排序+startIdx标记,过题代码如下:
class Solution {
private:
    vector<int> child;
    vector<vector<int>> result;
    int init = 0;
    void backTracking(vector<int>& nums, int start_idx){
        if(init == 0){
            sort(nums.begin(), nums.end());
            init++;
        }

        result.push_back(child);
        if(child.size() == nums.size()) return;
        for(int i = start_idx;i < nums.size();++i){
            if(i > start_idx && nums[i] == nums[i - 1]) continue;
            child.push_back(nums[i]);
            backTracking(nums, i + 1);
            child.pop_back();
        }
    }
public:
    vector<vector<int>> subsetsWithDup(vector<int>& nums) {
        backTracking(nums, 0);
        return result;
    }
};
这种去重思路实际上是在树的同一深度上去掉使用同一值的情况(如果把i > start_idx改成i > 0则是对一整条分支进行去重),此处不多赘述,之后或许会有专题博客讲这个吧......
可以看出来这道题还有一个比较特殊的,就是答案并不全部分布在叶子上,而是分布在所有节点上,所以这道题收获答案的这一步要直接加在每一轮递归进入循环之前。
简言之,回溯是一种暴力算法,但是也可以通过剪枝来优化整体的运行速度;他与多层循环嵌套相比理论时间复杂度不存在区别。观察他的思路以及代码结构,各位可能发现其与图论中的DFS有诸多相似(比如每个 path 只有在达到终点后才会结束递归回到上一层递归),所以回溯与“DFS“、“递归”等关键词是强绑定的,各位可以将相关思想进行交叉理解。